Nettstedstrategi i møte med kunstig intelligens
Hvordan formidle informasjon på nett, hvis brukerne går over fra nettsøk (som Google/Bing) til chatbot-søk (pr 2026: ChatGPT, Gemini og KI-oversikter) ?
Hva bør eiere av offentlige nettsteder (som for eksempel Utdanning.no og Ung.no) velge som strategi mot endringene i hvordan brukerne finner informasjon?
Bakgrunn: Våren 2026 innledet jobben min samarbeid med noen dyktige forskere fra SINTEF som undersøker hvordan unge bruker informasjon fra kunstig intelligens. Det kunne vært interessant om empiriske funn fra undersøkelsen som SINTEF skulle gjennomføre ble supplert med en drøftelse av hva nettsteder bør gjøres som mottiltak?
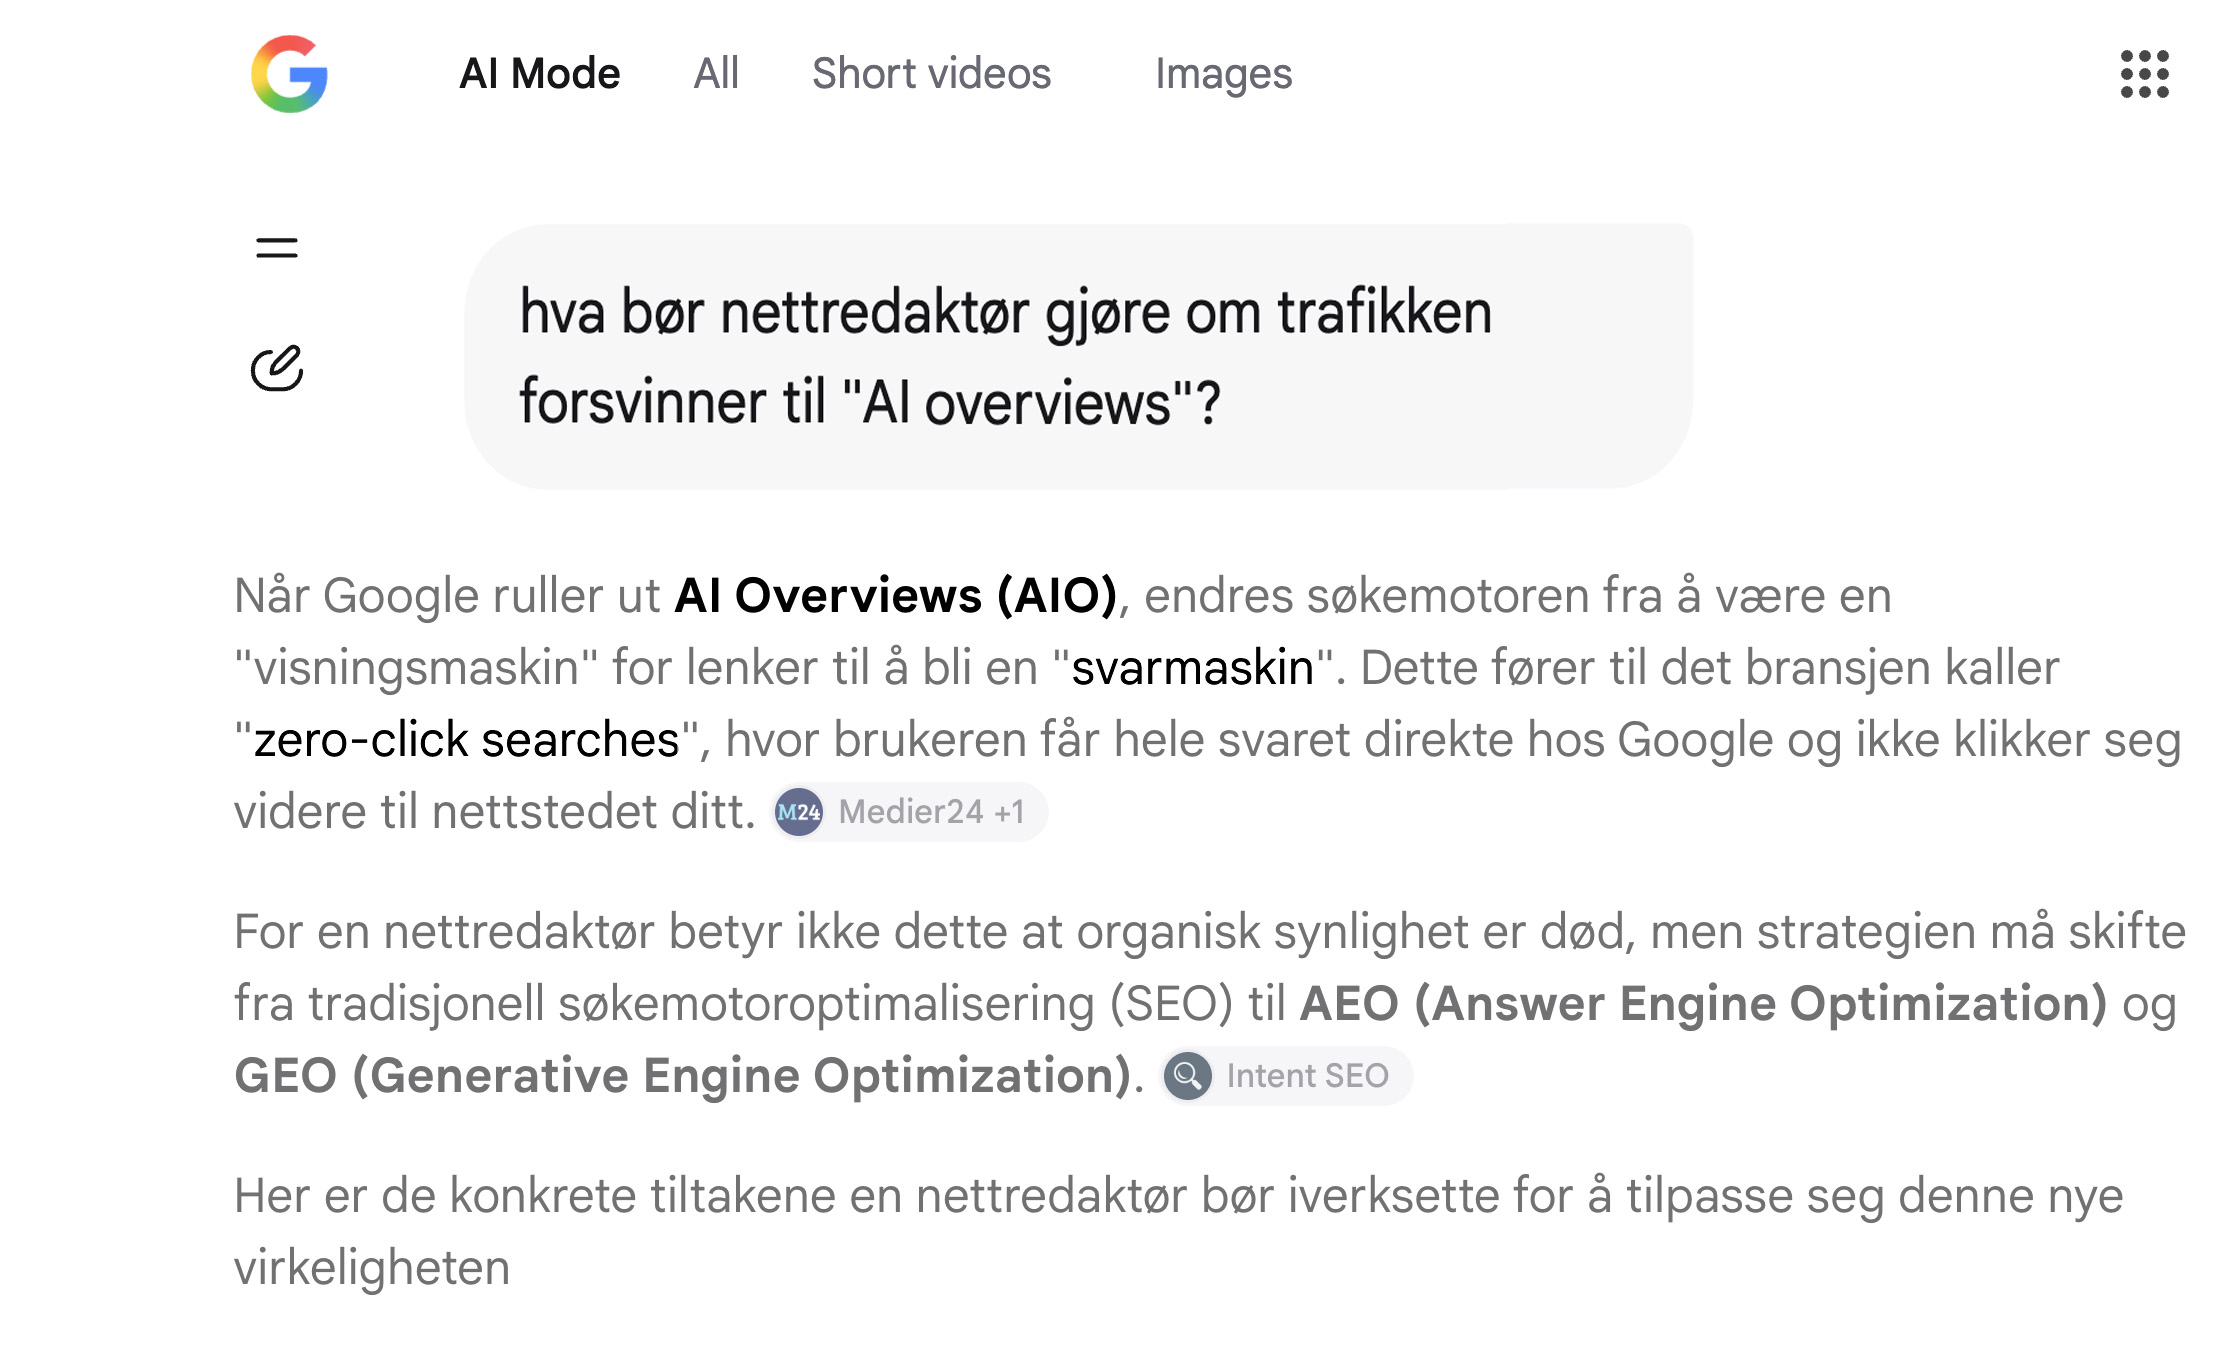
Her er en ikke-uttømmende med, litt karikerte, strategier som nettredaktører kan satse på i møte med kunstig intelligens:
Strategi: Fortsette som før 2022
Fortsette å legge ut nettsider med kvalitetssikret informasjon, men legge mindre vekt på brukertallene. Innholdet kan jo ha blitt indeksert av flere kunstig intelligens-tjenester, slik at brukernes spørsmål blir besvart med innhold blandet fra flere kilder. Hvilke kilder som blir valgt har jo nettstedet minimalt innflytelse over, så det er bare ta for gitt at KI-tjenestene kopierer alt innhold og bruker det som de vil?
Strategi: Bare gi opp!
Siden brukerne innen få år vil få svar på alt de lurer på gjennom kunstig intelligens, kan det offentlige bare gi opp å legge til rette informasjon på det åpne nettet. Innholdet kan jo uansett bli forvrengt og hallusinert, så hvorfor bruke ressurser på nettsider som uansett bare vil bli halvfabrikata i kunstig intelligens-tjenestenes presentasjon? Men: Hva vil skje sannhetsgehalten i KI-svarene når nettsidene som før var KI-tjenestenes kilde ikke lenger oppdateres? Hvor mye reklame og innholdsmarkedsføring vil brukerne bli utsatt for hvis det ikke lenger er et gratis og åpent alternativ til KI?
Strategi: Legge til rette for KI-gjenbruk
Optimere nettsidene med tanke på at en stor del av “leserne” kommer til å være KI-agenter og kunstig intelligens-indekseringsbot’er. Dette minner om søkemotoroptimering (“SEO”). Satse på at kunstig intelligens-tjenestene vil innse at de bør lenke tilbake til nettsidene svarene er hentet fra for å gi kunstig intelligens-svarene autoritet. Brukertallene til offentlige nettsider vil minke drastisk. Men en satser på at hvis vi legger ut korrekte data, som korrekt strukturert på nett, vil kunstig intelligens-tjenestene forhåpentligvis klare å bruke det til å gi brukerne rett svar.
Strategi: Forskyve til egne komparative fortrinn
Noen typer innhold gir kunstig intelligens-tjenestene bedre svar på enn lesing av ikke-personifiserte nettsider, ved at språkmodellene finner et slags gjennomsnitt av tekst på det åpne nettet. For eksempel er KI-tjenester for tiden ubrukelige til å regne ut hvilke studier en kan komme inn på, i motsetning til Utdanning.no’s karakterkalkulator, som gjør dette korrekt uten KI-teknologi. Bør offentlige nettsteder flytte ressursene over på de typer nettjenester som IKKE lar seg sluke av KI? Skal offentlige informasjonsnettsteder kompensere for det som kommersielle kunstig intelligens-tjenester ikke får til å svare på? Utdanning.no har hatt nesten halvering av trafikken til ikke-unikt tekstinnhold. Utdanning.no-innhold som språkmodeller ikke klarer å resonnere ut fra holder stand.
Strategi: Personifisering
Nettsteder kan regne det åpne, upersonifiserte nettet som tapt territorium. I stedet kan en satse på påloggingstjenester som kan utnytte persondata som det aldri vil være tillatt å dele med utenlandske kunstig intelligens-tjenester (GDPR m.m.). For eksempel kan Utdanning.no tilpasse alle sider til hva vi vet om brukerne ut fra karakterer og tidligere utdanning fra Vitnemålsportalen. Men hvordan skal innbyggerne få vite om at svaret på det de lurer på ikke er i KI-tjenesten de bruker til daglig, men bak en passordvegg som kunstig intelligens-tjenesten ikke kjenner til?
Strategi: Offentlige språkmodeller
Siden gratis åpne språkmodeller blir stadig bedre, kan offentlig sektor fininstille åpne modeller til å svare korrekt på sitt fagområde. Gjerne også bruke datakilder som er utilgjengelige for kommersielle KI. Dermed har en en viss innflytelse på hva kunstig intelligens-tjenesten svarer, og en kan unngå “drittifisering” (enshitification) av kunstig intelligens-svarene som følge av at investorene vil fylle kunstig intelligens-svar med reklame. Ulempen er jo at det er vanskelig å konkurrere med kommersielle generative tjenester som har titusen ganger så stort utviklingsbudsjett og alltid vil ligge noen år foran.
Ødelegger kunstig intelligens sine egne treningsdata?
Kommentarer til Åmås’ og Bolstads Aftenpostenkronikk Den nye kampen om definisjonsmakten 16.04.2026
Med en analogi til ernæringsdebatt, kan vi jo si at dette er som en overgang fra kontrollert lokalprodusert føde i informasjonsdietten, til ultraprosessert føde kjørt gjennom blenderen av språkmodeller og KI-tjenester … SNL er bekymret for at dette ultraprosesserte innholdet er blandet fra flere kilder og ikke stemmer med innholdsdeklarasjonen.
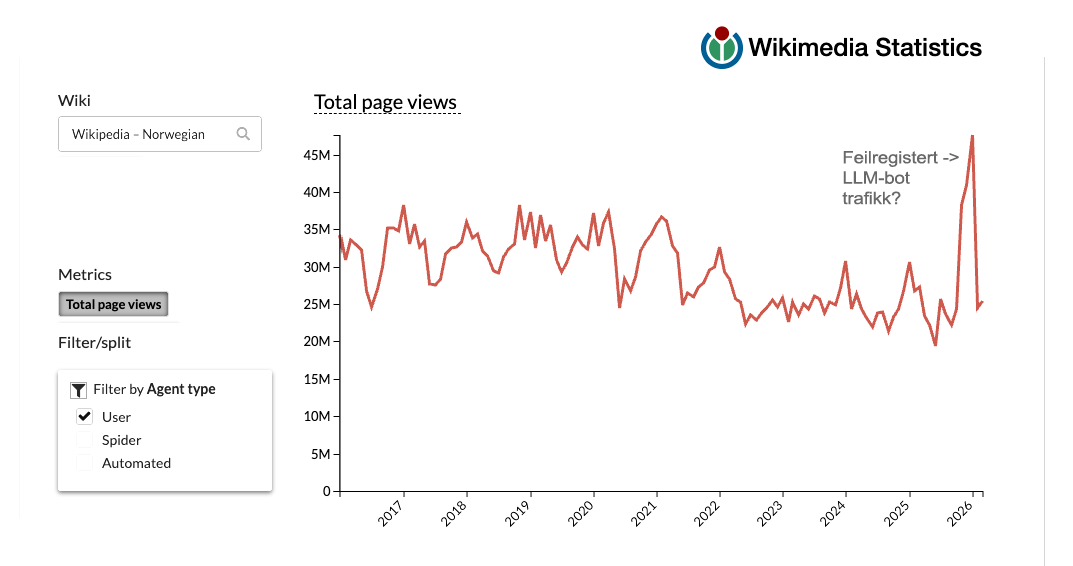
Trafikkovergang til KI gjelder jo ikke bare SNL, den norske utgaven av Wikipedia har hatt nedgang i trafikk på ca 20% siste ti år.
Catch22-situasjonen er jo at hvis KI-tjenestene gir korrekte svar, er det gjerne fordi de har høstet inn korrekte fra det åpne nettet (bla. Utdanning.no, Ung.no, SNL, Wikipedia osv.). Hvis brukerne går over til å finne alle svar fra KI-tjenester, vil insentivene til å holde de åpne datakildene oppdaterte minke. Hvis det åpne nettet ikke oppdateres, vil KI-tjenestene miste kilden som har sørget for at de har gitt korrekte svar. Offentlig finansierte nettsteder burde være bedre rustet til å motstå en slik utvikling.
Lenker
- The Economist AI is killing the web. Can anything save it? 14.07.2025
- Knut Olav Åmås og Erik Bolstad i SNL Den nye kampen om definisjonsmakten 16.04.2026
- Pew research Google users are less likely to click on links when an AI summary appears in the results 22.07.2025